Ingeniería de datos de código abierto con Spark, dbt y Airflow
Construir canalizaciones de datos de producción a escala
Así estudias: curso autodidacta
- Autodidacta y 100% en línea: contenido disponible 24/7.
- Avanzas a tu ritmo: la plataforma guarda tu progreso.
- Sin tutor ni clases en vivo: el curso está diseñado para estudiarse por tu cuenta.
- Te evalúas con actividades automáticas, sin entregas a un tutor.
Lo que serás capaz de hacer
Este programa le equipa con las herramientas de código abierto y el pensamiento arquitectónico utilizado por los ingenieros de datos profesionales para construir sistemas de datos escalables y fiables desde cero. Trabajará con Apache Spark para el procesamiento de datos distribuidos, dbt para la transformación modular basada en SQL y Apache Airflow para la orquestación de flujos de trabajo, la misma pila que alimenta la infraestructura de datos en organizaciones líderes en tecnología e impulsadas por datos en todo el mundo. A través de los cursos, obtendrá experiencia práctica en el diseño de modelos de datos dimensionales, la implementación de estrategias de carga incremental, la optimización del rendimiento del trabajo de Spark, la aplicación de la calidad de los datos con marcos de pruebas automatizadas y el despliegue de tuberías a través de flujos de trabajo de CI/CD. Al final de este programa, usted será capaz de diseñar e implementar tuberías de datos de extremo a extremo que ingieren de diversas fuentes, transforman los datos a través de modelos bien probados, y entregan conjuntos de datos listos para análisis a los consumidores aguas abajo - demostrando habilidades de ingeniería listos para el trabajo valorados a través de la ingeniería de análisis, plataforma de datos, y los roles de infraestructura de datos.
- Crea flujos de datos modulares y aptos para la producción utilizando Apache Spark, dbt y Airflow para recopilar, transformar y cargar datos a gran escala.
- Diseñar e implementar modelos de datos dimensionales, incluidos esquemas en estrella, SCD de tipo 2 y estrategias de carga incremental para almacenes de datos.
- Optimizar el procesamiento distribuido de datos resolviendo los problemas de «shuffle», «skew» y partición de Spark para mejorar el rendimiento del flujo de trabajo.
- Automatiza las implementaciones y garantiza la calidad de los datos mediante procesos de CI/CD, contenedores Docker y marcos de pruebas automatizadas como Great Expectations.
Temario
UNIDAD 1 - Fundamentos del diagrama de flujo de datos · 7 leccionesCreación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 1 - Fundamentos del diagrama de flujo de datos
Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 1 - Fundamentos del diagrama de flujo de datos
- Por qué la visualización del flujo de datos impulsa el éxito de la ingeniería
- Componentes esenciales de los diagramas de flujo de datos profesionales
- Enfoque sistemático para identificar fuentes y destinos
- Principios de mapeo de transformaciones para canalizaciones de datos complejas
- Creación de su primer diagrama de flujo de datos
- Planificación de su primer diagrama de flujo de datos
- Fundamentos del flujo de datos Comprobación de conocimientos
UNIDAD 2 - Creación de diagramas de flujo de datos completos · 8 leccionesCreación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 2 - Creación de diagramas de flujo de datos completos
Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 2 - Creación de diagramas de flujo de datos completos
- Mejore sus habilidades de visualización del flujo de datos
- Técnicas avanzadas de diagramación para sistemas de datos complejos
- Mejores prácticas de flujo de datos empresariales y normas del sector
- Trazado de complejas cadenas de datos multisistema
- Procesos de validación y revisión de la documentación sobre flujos de datos
- Crear un diagrama completo de flujo de datos de la empresa
- Conceptos avanzados de flujo de datos Comprobación de conocimientos
- Evaluación exhaustiva del dominio del flujo de datos
UNIDAD 3 - Desarrollo modular de tuberías - Base y núcleo · 4 leccionesCreación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 3 - Desarrollo modular de tuberías - Base y núcleo
Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 3 - Desarrollo modular de tuberías - Base y núcleo
- Fundamentos de la arquitectura modular de canalización de datos
- Ecosistema de herramientas de código abierto: Integración de Spark, dbt y Airflow
- Diseño de interfaces de componentes y contratos de datos
- Evaluación de los fundamentos del diseño modular de tuberías
UNIDAD 4 - Implantación e integración de tuberías - Aplicación y evaluación · 6 leccionesCreación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 4 - Implantación e integración de tuberías - Aplicación y evaluación
Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 4 - Implantación e integración de tuberías - Aplicación y evaluación
- Valor estratégico de la arquitectura modular de gasoductos
- Patrones de integración de canalizaciones de extremo a extremo
- Implementación de la integración completa de canalizaciones con Spark, dbt y Airflow
- Proyecto integral de desarrollo de oleoductos
- Cuestionario modular de integración y coordinación de tuberías
- Evaluación modular completa del desarrollo de oleoductos y gasoductos
UNIDAD 5 - Fundamentos de la configuración de conectores · 6 leccionesCreación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 5 - Fundamentos de la configuración de conectores
Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 5 - Fundamentos de la configuración de conectores
- Por qué la unificación de fuentes de datos es importante para el éxito de la empresa
- Comprender la arquitectura de conectores y los patrones de integración
- Fundamentos del conector Airbyte - Su base de integración
- Guía profesional: Configuración paso a paso de su primer conector de base de datos
- Planificación de conectores para su contexto laboral
- Comprobación de los conocimientos de la Connector Configuration Foundation
UNIDAD 6 - Integración unificada de datos · 7 leccionesCreación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 6 - Integración unificada de datos
Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 6 - Integración unificada de datos
- Éxitos de la integración empresarial: por qué es importante la unidad multifuente
- Autenticación y patrones de seguridad para conectores de producción
- Dominio de streaming y configuración de conectores API
- Integración de datos de múltiples fuentes: Guía práctica
- Desarrollo de una estrategia de integración de múltiples fuentes
- Verificación de la configuración de la integración multifuente
- Evaluación del dominio de la configuración de conectores
UNIDAD 7 - SCD2 Fundamentos del seguimiento histórico · 6 leccionesCreación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 7 - SCD2 Fundamentos del seguimiento histórico
Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 7 - SCD2 Fundamentos del seguimiento histórico
- Por qué SCD2 es importante en los almacenes de datos empresariales
- Comprender los componentes CORE y la lógica empresarial de SCD2
- SCD2 Patrones de implementación y diseño de modelos de datos
- Creación de la primera estructura de tabla SCD2 en SQL
- Análisis de su estrategia de implantación de SCD2
- Comprobación de los conocimientos básicos de SCD2
UNIDAD 8 - dbt Implantación del modelo SCD2 · 8 leccionesCreación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 8 - dbt Implantación del modelo SCD2
Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 8 - dbt Implantación del modelo SCD2
- dbt SCD2 Mastery: comprueba tu nivel de confianza en la implementación
- Por qué dbt transforma la implantación de SCD2 para los equipos de datos
- instantáneas dbt para la detección automatizada de cambios en SCD2
- dbt SCD2 Patrones de implantación y consideraciones relativas a la producción
- Creación de un modelo SCD2 dbt completo con períodos de validez
- Creación de un modelo de datos SCD2 de producción para las dimensiones de los productos
- dbt Comprobación de los conocimientos de implantación de SCD2
- Evaluación del dominio de la aplicación de SCD2
UNIDAD 9 - Principios de diseño del flujo de trabajo - Fundación · 6 leccionesCreación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 9 - Principios de diseño del flujo de trabajo - Fundación
Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 9 - Principios de diseño del flujo de trabajo - Fundación
- El coste de los frágiles conductos de datos
- Fundamentos de Apache Airflow para flujos de trabajo de producción
- Principios de diseño para flujos de trabajo de datos sólidos
- Construya su primera estructura DAG lista para producción
- Diseño de la arquitectura de flujos de trabajo para garantizar la resiliencia de la producción
- Evaluación de los principios de diseño del flujo de trabajo
UNIDAD 10 - Implantación de la producción - Aplicación y evaluación CORE · 7 leccionesCreación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 10 - Implantación de la producción - Aplicación y evaluación CORE
Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 10 - Implantación de la producción - Aplicación y evaluación CORE
- Cuando los flujos de trabajo de producción ahorran operaciones empresariales
- Patrones de implantación de la producción y mejores prácticas
- Aplicación de patrones de producción avanzados en Airflow
- Marco de decisión del patrón de producción
- Creación de DAG de flujo de aire listos para la producción con lógica de reintentos y supervisión de SLA
- Evaluación de los patrones de implantación de la producción
- Evaluación del dominio del flujo de trabajo de producción
UNIDAD 11 - Proyecto: Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow · 5 leccionesCreación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 11 - Proyecto: Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow
Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow - UNIDAD 11 - Proyecto: Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow
- Por qué es importante este proyecto
- Requisitos del proyecto
- Asignación: Sistema de automatización de canalización de datos
- Cuestionario graduado: Creación de canalizaciones de datos automatizadas con Spark, dbt y Airflow
- Clave de la solución
UNIDAD 12 - Fundación para el Análisis del Rendimiento de Spark · 6 leccionesOptimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 12 - Fundación para el Análisis del Rendimiento de Spark
Optimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 12 - Fundación para el Análisis del Rendimiento de Spark
- Cuando los conductos de datos se bloquean: Una crisis de rendimiento
- Fundamentos de Spark UI: cómo interpretar los datos de rendimiento
- Identificación de cuellos de botella en el rendimiento: patrones y soluciones
- Navegación por la interfaz de usuario de Spark para la optimización del rendimiento
- Toma de decisiones sobre optimización estratégica
- Desafío de análisis de Spark UI
UNIDAD 13 - Análisis del rendimiento y optimización · 8 leccionesOptimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 13 - Análisis del rendimiento y optimización
Optimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 13 - Análisis del rendimiento y optimización
- De 4 horas a 5 minutos: El éxito de la optimización de Netflix
- Estrategias de partición: cómo minimizar el movimiento de datos
- Estrategias de almacenamiento en caché: reducción de los costes de cálculo
- Optimización de la partición y el almacenamiento en caché
- Validación de estrategias de optimización y resolución de problemas
- Implementar el almacenamiento en caché y la partición para optimizar el rendimiento de Spark
- Técnicas de optimización y análisis del rendimiento de Spark
- Evaluación exhaustiva de la optimización de Spark
UNIDAD 14 - Analizar los planes de ejecución de Spark · 9 leccionesOptimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 14 - Analizar los planes de ejecución de Spark
Optimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 14 - Analizar los planes de ejecución de Spark
- Por qué el análisis del rendimiento evita que los equipos de datos se enfrenten a desastres en los procesos de tratamiento de datos
- Comprender la arquitectura de ejecución distribuida de Spark
- Reordenación y sesgo de datos: los factores ocultos que merman el rendimiento
- Interpretación de las métricas de ejecución visual y los indicadores de rendimiento
- Navegación por la interfaz de supervisión de la ejecución de Spark
- Identificación de patrones de cuellos de botella en las métricas de ejecución de tareas
- Debate sobre la estrategia de análisis del rendimiento
- Detectar cuellos de botella en el rendimiento mediante el análisis del plan de ejecución
- Prueba de conocimientos: Fundamentos del análisis del plan de ejecución
UNIDAD 15 - Resolver los cuellos de botella en el rendimiento · 6 leccionesOptimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 15 - Resolver los cuellos de botella en el rendimiento
Optimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 15 - Resolver los cuellos de botella en el rendimiento
- Estrategias de partición y técnicas de optimización de la unión por difusión
- Optimización de la configuración: ajuste de Spark para obtener el máximo rendimiento
- Debate sobre la estrategia de optimización y su implementación
- Optimizar el escenario de rendimiento en condiciones reales
- Prueba de conocimientos: Estrategias de optimización del rendimiento
- Evaluación final: Análisis exhaustivo de los cuellos de botella en el rendimiento y su resolución
UNIDAD 16 - Aplicar funciones de transacciones y control de versiones - Fundamentos · 6 leccionesOptimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 16 - Aplicar funciones de transacciones y control de versiones - Fundamentos
Optimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 16 - Aplicar funciones de transacciones y control de versiones - Fundamentos
- Por qué los lagos de datos transaccionales transforman la fiabilidad de los datos empresariales
- Comprender las transacciones ACID y el control de versiones en los lagos de datos
- Arquitectura de Delta Lake y funcionamiento del registro de transacciones
- Conversión de tablas Parquet al formato Delta
- Implementación de funciones transaccionales y de control de versiones en las tablas de Data Lake
- Prueba de conocimientos sobre funciones transaccionales y de control de versiones
UNIDAD 17 - Aplicar funciones transaccionales y de control de versiones: aplicación CORE y evaluación · 6 leccionesOptimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 17 - Aplicar funciones transaccionales y de control de versiones: aplicación CORE y evaluación
Optimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 17 - Aplicar funciones transaccionales y de control de versiones: aplicación CORE y evaluación
- Por qué los fallos en los datos de producción exigen soluciones de nivel empresarial
- Operaciones de escritura atómica y eliminaciones condicionales
- Consulta de versiones históricas y verificación de las capacidades de reversión
- Implementación de operaciones transaccionales en tablas de análisis de clientes
- Prueba de conocimientos sobre operaciones de control de versiones
- Evaluación de los conocimientos sobre funciones transaccionales y de control de versiones
UNIDAD 18 - Fundamentos de seguridad en la nube · 7 leccionesOptimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 18 - Fundamentos de seguridad en la nube
Optimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 18 - Fundamentos de seguridad en la nube
- Por qué las brechas de seguridad en la nube cuestan millones a las empresas
- Principios básicos de la arquitectura de seguridad en la nube
- Infraestructura como código: buenas prácticas de seguridad
- Análisis de patrones de configuración de Terraform seguro
- Evaluación de tus conocimientos y objetivos en materia de seguridad en la nube
- Diseño seguro de infraestructuras en la nube
- Fundamentos de seguridad en la nube Comprobación de conocimientos
UNIDAD 19 - Implementación de una infraestructura segura · 7 leccionesOptimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 19 - Implementación de una infraestructura segura
Optimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 19 - Implementación de una infraestructura segura
- Cómo escala Netflix su infraestructura de datos segura
- Implementación de almacenamiento seguro en S3 con Terraform
- Patrones de seguridad IAM para infraestructuras de datos
- Planificación de la implementación de tu infraestructura segura
- Infraestructura de datos segura con Terraform
- Comprobación de la implantación de una infraestructura segura
- Evaluación del dominio de la infraestructura de nube segura
UNIDAD 20 - Fundamentos de la evaluación de la arquitectura de almacenamiento · 6 leccionesOptimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 20 - Fundamentos de la evaluación de la arquitectura de almacenamiento
Optimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 20 - Fundamentos de la evaluación de la arquitectura de almacenamiento
- Por qué las decisiones sobre el formato de almacenamiento determinan el rendimiento de los análisis
- Almacenamiento columnar frente a almacenamiento orientado a filas: conceptos básicos y ventajas e inconvenientes
- Análisis en profundidad de los formatos de almacenamiento: características de rendimiento y casos de uso
- Análisis de las ventajas e inconvenientes de los formatos de almacenamiento: un enfoque sistemático
- Aplica el marco de evaluación del almacenamiento a tu reto analítico
- Prueba de conocimientos sobre formatos de almacenamiento
UNIDAD 21 - Análisis comparativo del rendimiento y recomendaciones · 8 leccionesOptimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 21 - Análisis comparativo del rendimiento y recomendaciones
Optimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 21 - Análisis comparativo del rendimiento y recomendaciones
- Por qué el análisis comparativo es mejor que las suposiciones sobre las mejores prácticas
- Metodologías de evaluación comparativa empresarial: de Netflix a Cloudflare
- Interpretación de los datos sobre el rendimiento de los formatos de almacenamiento
- Cómo convertir los resultados de las pruebas de rendimiento en valor empresarial
- Informes de recomendaciones profesionales: cómo convertir los puntos de referencia en valor empresarial
- Crear un informe profesional con recomendaciones de almacenamiento
- Prueba de conocimientos sobre evaluación comparativa del rendimiento
- Decisión sobre la arquitectura de almacenamiento: análisis exhaustivo y recomendación
UNIDAD 22 - Proyecto: Optimización de Spark y del almacenamiento de datos en la nube para el análisis de datos · 5 leccionesOptimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 22 - Proyecto: Optimización de Spark y del almacenamiento de datos en la nube para el análisis de datos
Optimización de Spark y el almacenamiento de datos en la nube para análisis - UNIDAD 22 - Proyecto: Optimización de Spark y del almacenamiento de datos en la nube para el análisis de datos
- Por qué es importante este proyecto
- Requisitos del proyecto
- Trabajo: Proyecto de optimización de la infraestructura de datos
- Prueba evaluada: Optimización de Spark y el almacenamiento de datos en la nube para el análisis de datos
- Clave de la solución
UNIDAD 23 - Fundamentos del esquema en estrella · 7 leccionesModelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 23 - Fundamentos del esquema en estrella
Modelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 23 - Fundamentos del esquema en estrella
- Descubra su viaje de modelado de datos y sus objetivos de BI
- Principios de modelado dimensional y componentes de Star Schema
- Identificación de procesos empresariales y definición del modelo de grano
- Patrones de diseño de tablas de hechos y dimensiones
- Creación de relaciones de esquema estrella y claves sustitutas
- Diseño de esquema en estrella para el análisis de autoservicio
- Comprobación de conocimientos sobre el diseño del esquema Star
UNIDAD 24 - Implementación del modelo de BI · 6 leccionesModelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 24 - Implementación del modelo de BI
Modelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 24 - Implementación del modelo de BI
- Exploración de su estrategia de implementación de modelos de BI
- Implementación de dimensiones que cambian lentamente y patrones de diseño avanzados
- Documentación de modelos de datos para el éxito de la inteligencia empresarial
- Implementar un esquema en estrella completo con documentación
- Evaluación de conocimientos sobre la estrategia de implementación
- Evaluación de dominio del diseño de esquemas en estrella
UNIDAD 25 - Fundamentos de la normalización de bases de datos · 5 leccionesModelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 25 - Fundamentos de la normalización de bases de datos
Modelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 25 - Fundamentos de la normalización de bases de datos
- Explorar los retos del diseño de bases de datos
- Cómo identificar oportunidades de normalización en las bases de datos empresariales
- Proceso paso a paso de normalización de bases de datos
- Identificación y planificación de mejoras en la normalización de bases de datos
- Prueba de conocimientos sobre normalización de bases de datos
UNIDAD 26 - Optimización del rendimiento · 7 leccionesModelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 26 - Optimización del rendimiento
Modelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 26 - Optimización del rendimiento
- Por qué es importante el rendimiento en las bases de datos normalizadas
- Indexación estratégica y optimización de consultas para bases de datos normalizadas
- Tipos de índices y su impacto en el rendimiento de los sistemas de bases de datos
- Implementación de la normalización de bases de datos optimizada para el rendimiento
- Cómo aplicar la optimización del rendimiento a tus bases de datos normalizadas
- Prueba de conocimientos sobre optimización del rendimiento
- Evaluación de dominio de la normalización de bases de datos
UNIDAD 27 - Aplicación de funciones de ventana de SQL: conceptos básicos · 6 leccionesModelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 27 - Aplicación de funciones de ventana de SQL: conceptos básicos
Modelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 27 - Aplicación de funciones de ventana de SQL: conceptos básicos
- Por qué las funciones ventana transforman el análisis de la ingeniería de datos
- Introducción a las funciones de ventana y a la cláusula OVER()
- Sintaxis y componentes esenciales de las funciones de ventana
- Fundamentos de PARTITION BY y ORDER BY
- Análisis de los patrones de consultas con funciones de ventana
- Evaluación de los fundamentos de la función de ventana
UNIDAD 28 - Cálculo de métricas móviles y basadas en la clasificación: aplicación y evaluación · 7 leccionesModelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 28 - Cálculo de métricas móviles y basadas en la clasificación: aplicación y evaluación
Modelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 28 - Cálculo de métricas móviles y basadas en la clasificación: aplicación y evaluación
- Repercusiones en la vida real de las funciones de ventana avanzadas
- Cálculos de rodadura y especificaciones del bastidor
- Funciones de clasificación y aplicaciones prácticas
- Comprobación del dominio de las funciones avanzadas de Windows: evaluación de su confianza en la aplicación
- Análisis avanzado con funciones de ventana
- Evaluación de funciones avanzadas de Windows
- Evaluación de dominio de las funciones de ventana de SQL
UNIDAD 29 - Fundamentos de la replicación de bases de datos · 6 leccionesModelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 29 - Fundamentos de la replicación de bases de datos
Modelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 29 - Fundamentos de la replicación de bases de datos
- Por qué la replicación de bases de datos salva a su empresa de un desastre
- Comprender la replicación en tiempo real y las ranuras de replicación física
- Análisis en profundidad de los componentes y la arquitectura de la replicación de PostgreSQL
- Configuración de ranuras de replicación física paso a paso
- Evaluación de su estrategia de replicación
- Comprobación de conocimientos sobre los fundamentos de la replicación de bases de datos
UNIDAD 30 - Aplicación y seguimiento · 5 leccionesModelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 30 - Aplicación y seguimiento
Modelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 30 - Aplicación y seguimiento
- Planificación de la implementación de alta disponibilidad
- Configuración avanzada de la replicación y optimización del rendimiento
- Supervisión del estado de la replicación con pg_stat_replication
- Comprobación de dominio de la implementación y el seguimiento
- Implementación de alta disponibilidad en la base de datos de producción
UNIDAD 31 - Estrategias de carga incremental - Fundamentos · 8 leccionesModelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 31 - Estrategias de carga incremental - Fundamentos
Modelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 31 - Estrategias de carga incremental - Fundamentos
- Por qué la carga incremental transforma la ingeniería de datos
- Conceptos básicos de la carga incremental
- Arquitectura y patrones de las tablas de preparación
- Lógica de selección y emparejamiento de claves de negocio
- Podcast: Dominio de la instrucción MERGE para la carga incremental
- Análisis de escenarios de carga incremental
- Análisis de cimientos con carga incremental
- Evaluación de conocimientos básicos sobre la carga incremental
UNIDAD 32 - Implementación de la instrucción MERGE: aplicación CORE y evaluación · 7 leccionesModelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 32 - Implementación de la instrucción MERGE: aplicación CORE y evaluación
Modelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 32 - Implementación de la instrucción MERGE: aplicación CORE y evaluación
- Contexto de implementación profesional y patrones empresariales
- Patrones de producción y técnicas avanzadas de MERGE
- Integración de flujos de trabajo empresariales y mejores prácticas
- Guía paso a paso completa para la implementación de la carga incremental
- Análisis de la estrategia de implementación de la producción
- Prueba de conocimientos sobre la implementación de MERGE
- Evaluación de dominio de la carga incremental
UNIDAD 33 - Proyecto: Fundamentos del modelado y el almacenamiento de datos para la ingeniería de datos · 5 leccionesModelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 33 - Proyecto: Fundamentos del modelado y el almacenamiento de datos para la ingeniería de datos
Modelado y almacenamiento de datos Fundamentos de la ingeniería de datos - UNIDAD 33 - Proyecto: Fundamentos del modelado y el almacenamiento de datos para la ingeniería de datos
- Por qué es importante este proyecto
- Requisitos del proyecto
- Trabajo: Implementación de un almacén de datos empresarial
- Prueba evaluativa: Fundamentos de modelización de datos y almacenamiento de datos para la ingeniería de datos
- Clave de la solución
UNIDAD 34 - Aplicar técnicas de resolución de conflictos de fusión · 5 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 34 - Aplicar técnicas de resolución de conflictos de fusión
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 34 - Aplicar técnicas de resolución de conflictos de fusión
- Aplicación de estrategias de resolución de conflictos en situaciones reales
- Comprender los conflictos de fusión: Desafíos de texto frente a binarios
- Matriz de decisión para la resolución de conflictos destinada a ingenieros de datos
- Resolución de conflictos de texto en archivos de esquema SQL
- Evaluación de conocimientos sobre resolución de conflictos
UNIDAD 35 - Analizar el historial de confirmaciones para la localización de errores · 7 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 35 - Analizar el historial de confirmaciones para la localización de errores
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 35 - Analizar el historial de confirmaciones para la localización de errores
- Por qué Git Forensics transforma la depuración de conjeturas en ciencia
- Git Bisect: Algoritmo de búsqueda binaria para la detección de errores
- Técnicas avanzadas de análisis del historial de Git
- Git Bisect automatizado con scripts de prueba personalizados
- Desarrollo de una estrategia de depuración sistemática
- Evaluación de conocimientos sobre el seguimiento de errores y el análisis del historial de Git
- Resolución de conflictos en la fusión de esquemas SQL
UNIDAD 36 - Fundamentos de la estrategia de ramificación · 6 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 36 - Fundamentos de la estrategia de ramificación
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 36 - Fundamentos de la estrategia de ramificación
- Por qué es importante la estrategia de control de versiones en los equipos de ingeniería de datos
- Comprender los modelos de bifurcación y los patrones de colaboración en equipo
- Convenciones de denominación de ramas y diseño del protocolo de fusión
- Análisis de los requisitos del flujo de trabajo del equipo para la selección de la estrategia
- Diseña la documentación del flujo de trabajo ramificado de tu equipo
- Evaluación de conocimientos sobre los fundamentos de la estrategia de ramificación
UNIDAD 37 - Implementación y diseño de procesos · 7 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 37 - Implementación y diseño de procesos
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 37 - Implementación y diseño de procesos
- Ampliación de los equipos de desarrollo mediante una implementación estratégica
- Reglas de protección de ramas de GitHub y automatización de flujos de trabajo
- Configuración de la protección de ramas de GitHub y las revisiones obligatorias
- Configuración de GitHub Actions automatizadas para flujos de trabajo de ramas
- Evaluación de los retos y soluciones de la implantación de GitHub
- Evaluación de conocimientos sobre la implementación de GitHub y la automatización de flujos de trabajo
- Proyecto de implementación completa de la estrategia de ramificación
UNIDAD 38 - Conceptos básicos sobre contenedores y archivos Dockerfile de varias etapas · 7 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 38 - Conceptos básicos sobre contenedores y archivos Dockerfile de varias etapas
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 38 - Conceptos básicos sobre contenedores y archivos Dockerfile de varias etapas
- Por qué la contenedorización transforma los flujos de trabajo de la ingeniería de datos
- Conceptos básicos sobre contenedores para entornos de procesamiento de datos
- Arquitectura de Dockerfile en varias etapas para el procesamiento de datos
- Creación de archivos Docker multietapa para el procesamiento de datos de Spark
- Planificación de estrategias de contenedorización para entornos de procesamiento de datos
- Crear un archivo Dockerfile de varias etapas listo para producción destinado al procesamiento de datos
- Prueba de conocimientos sobre conceptos básicos de contenedores
UNIDAD 39 - Control de versiones de imágenes y publicación en el registro · 7 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 39 - Control de versiones de imágenes y publicación en el registro
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 39 - Control de versiones de imágenes y publicación en el registro
- Propuesta de valor de la integración con el registro de contenedores empresarial
- Etiquetado sistemático de imágenes de contenedores para la infraestructura de datos
- Patrones de integración de Amazon ECR para equipos de ingeniería de datos
- Configuración del repositorio de Amazon ECR y la autenticación
- Escenarios de integración de la implantación y planificación estratégica
- Conceptos sobre la integración del registro de contenedores y el flujo de trabajo de implementación
- Evaluación completa del dominio del flujo de trabajo de contenedorización
UNIDAD 40 - Fundamentos de la gestión de la configuración · 6 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 40 - Fundamentos de la gestión de la configuración
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 40 - Fundamentos de la gestión de la configuración
- El reto de las infraestructuras: Del caos manual a la excelencia automatizada
- Fundamentos de la gestión de la configuración para la infraestructura de datos
- Arquitectura de Ansible y flujo de trabajo de automatización
- Cómo planificar tu primer proyecto de automatización con Ansible
- Diseñe su primera estrategia de gestión de la configuración
- Prueba de conocimientos sobre los fundamentos de Ansible
UNIDAD 41 - Implementación de la automatización con Ansible · 8 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 41 - Implementación de la automatización con Ansible
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 41 - Implementación de la automatización con Ansible
- Casos de éxito en la automatización empresarial: del caos manual a una infraestructura escalable
- Introducción a los playbooks de Ansible: componentes y estructura
- Funciones avanzadas de Playbook: variables, plantillas y gestión de errores
- Cómo implementar un servidor web completo en Python
- Optimización de los playbooks de Ansible para entornos de producción
- Crear guías de Ansible para la instalación automatizada de software
- Prueba de conocimientos sobre la implementación de la automatización con Ansible
- Evaluación de dominio de la automatización con Ansible
UNIDAD 42 - Fundamentos del proceso de CI/CD · 6 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 42 - Fundamentos del proceso de CI/CD
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 42 - Fundamentos del proceso de CI/CD
- Por qué las implantaciones automatizadas transforman las operaciones de datos
- Arquitectura de la cadena de CI/CD para sistemas de datos
- Herramientas y tecnologías esenciales de CI/CD para equipos de datos
- Configuración de tu primer flujo de trabajo de GitHub Actions
- Exploración de escenarios de implantación de CI/CD
- Evaluación de conocimientos sobre los fundamentos del proceso de CI/CD
UNIDAD 43 - Implementación automatizada de datos · 8 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 43 - Implementación automatizada de datos
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 43 - Implementación automatizada de datos
- Síntesis de la implementación de un proceso de CI/CD para sistemas de datos de producción
- Retos en la implementación de datos empresariales y soluciones de automatización
- Acciones avanzadas de GitHub para implementaciones en producción
- Estrategias de supervisión y validación para implementaciones automatizadas
- Creación de una canalización completa de despliegue de acciones de GitHub
- Despliegue automatizado de canalizaciones de datos con acciones de GitHub
- Prueba de conocimientos sobre automatización avanzada de la implementación de datos
- Evaluación exhaustiva de la implantación del proceso CI/CD
UNIDAD 44 - Fundamentos del análisis del rendimiento de las consultas · 7 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 44 - Fundamentos del análisis del rendimiento de las consultas
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 44 - Fundamentos del análisis del rendimiento de las consultas
- Por qué el análisis del rendimiento de las consultas evita los fallos del sistema
- Fundamentos del rendimiento de las consultas para ingenieros de datos
- Herramientas y técnicas de supervisión del rendimiento de PostgreSQL
- Interpretación de los planes de ejecución de consultas con fines de optimización
- Uso de pg_stat_activity para identificar problemas de rendimiento
- Aplicación del análisis del rendimiento en entornos de producción
- Prueba de conocimientos sobre el análisis del rendimiento de PostgreSQL
UNIDAD 45 - Asignación y optimización de recursos · 6 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 45 - Asignación y optimización de recursos
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 45 - Asignación y optimización de recursos
- Planificación estratégica para la optimización del rendimiento
- Asignación estratégica de recursos de bases de datos para la optimización del rendimiento
- Asignación estratégica de recursos para los acuerdos de nivel de servicio
- Implementación de la optimización de la memoria y los índices en PostgreSQL
- Prueba de conocimientos sobre la asignación de recursos en PostgreSQL
- Análisis del rendimiento de las consultas y dominio de la asignación de recursos
UNIDAD 46 - Proyecto: DevOps e integración continua/entrega continua (CI/CD) para el rendimiento de la ingeniería de datos · 5 leccionesDevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 46 - Proyecto: DevOps e integración continua/entrega continua (CI/CD) para el rendimiento de la ingeniería de datos
DevOps y CI/CD para el rendimiento de la ingeniería de datos - UNIDAD 46 - Proyecto: DevOps e integración continua/entrega continua (CI/CD) para el rendimiento de la ingeniería de datos
- Por qué es importante este proyecto
- Requisitos del proyecto
- Tarea: Flujo de trabajo de ingeniería de datos de DevOps CI/CD
- Prueba evaluada: DevOps e integración continua/entrega continua (CI/CD) para el rendimiento de la ingeniería de datos
- Clave de la solución
UNIDAD 47 - Fundamentos del marco de calidad de los datos · 6 leccionesCalidad y depuración de datos para canalizaciones fiables - UNIDAD 47 - Fundamentos del marco de calidad de los datos
Calidad y depuración de datos para canalizaciones fiables - UNIDAD 47 - Fundamentos del marco de calidad de los datos
- Por qué los marcos de calidad de datos evitan fracasos millonarios en las canalizaciones
- Componentes esenciales de los marcos de calidad de los datos
- Patrones de pruebas de calidad de datos y estrategias de implementación
- Implementación de pruebas básicas de calidad de datos con SQL
- Evalúa tu nivel de preparación en materia de calidad de los datos y establece objetivos de aprendizaje
- Prueba de conocimientos básicos sobre el marco de calidad de los datos
UNIDAD 48 - Implementación de pruebas automatizadas · 9 leccionesCalidad y depuración de datos para canalizaciones fiables - UNIDAD 48 - Implementación de pruebas automatizadas
Calidad y depuración de datos para canalizaciones fiables - UNIDAD 48 - Implementación de pruebas automatizadas
- Cómo las pruebas automatizadas ahorran a los ingenieros de datos llamadas de crisis a medianoche
- Configuración de pruebas basada en YAML e integración con Great Expectations
- Pruebas listas para la producción con dbt y Great Expectations
- Creación de conjuntos de pruebas YAML para la validación en producción
- Planifique su estrategia de implantación de pruebas de calidad
- Implementación automatizada de un flujo de datos
- Despliegue automatizado de canalizaciones de datos con acciones de GitHub
- Evaluación de dominio de la implementación de pruebas automatizadas
- Evaluación del dominio del marco de calidad de datos
UNIDAD 49 - Investigación sistemática sobre la calidad de los datos · 6 leccionesCalidad y depuración de datos para canalizaciones fiables - UNIDAD 49 - Investigación sistemática sobre la calidad de los datos
Calidad y depuración de datos para canalizaciones fiables - UNIDAD 49 - Investigación sistemática sobre la calidad de los datos
- Por qué son cruciales las habilidades de investigación de canalizaciones de datos
- Marco de investigación de la calidad de los datos: De la supervisión a la causa raíz
- Análisis del cuadro de mandos: Detección de problemas en los oleoductos
- Navegación por los paneles de control para identificar patrones de anomalías en los datos
- Investigación sistemática de anomalías en el flujo de datos
- Evaluación de los fundamentos de la investigación sobre la calidad de los datos
UNIDAD 50 - Estrategias para la resolución de anomalías en las tuberías · 7 leccionesCalidad y depuración de datos para canalizaciones fiables - UNIDAD 50 - Estrategias para la resolución de anomalías en las tuberías
Calidad y depuración de datos para canalizaciones fiables - UNIDAD 50 - Estrategias para la resolución de anomalías en las tuberías
- Cuando las reparaciones de las tuberías se convierten en héroes de la producción
- Resolución de anomalías en tuberías: un enfoque estructurado
- Implementación de correcciones específicas: soluciones SQL y restauración del proceso
- Aplicación de correcciones SQL y validación de la restauración del proceso
- Validación de la eficacia de las correcciones en el proceso de desarrollo mediante pruebas sistemáticas
- Validación de la estrategia de resolución de la cartera de proyectos
- Evaluación exhaustiva de la solución de problemas de canalización de datos
UNIDAD 51 - Técnicas avanzadas de depuración · 7 leccionesCalidad y depuración de datos para canalizaciones fiables - UNIDAD 51 - Técnicas avanzadas de depuración
Calidad y depuración de datos para canalizaciones fiables - UNIDAD 51 - Técnicas avanzadas de depuración
- Cuando fallan los procesos de producción: el coste de una depuración deficiente
- Fundamentos avanzados de depuración para flujos de trabajo en Python
- Puntos de interrupción condicionales y técnicas de inspección de la memoria
- Configuración de puntos de interrupción condicionales en el código de producción
- Aplicación de la inspección de memoria en escenarios reales de canalización
- Depuración condicional práctica en un proceso de múltiples lotes
- Prueba de conocimientos sobre técnicas avanzadas de depuración
UNIDAD 52 - Análisis de la traza de pila y de los registros · 8 leccionesCalidad y depuración de datos para canalizaciones fiables - UNIDAD 52 - Análisis de la traza de pila y de los registros
Calidad y depuración de datos para canalizaciones fiables - UNIDAD 52 - Análisis de la traza de pila y de los registros
- La complejidad oculta de la depuración multihilo
- Comprender los rastros de pila en entornos multihilo
- Técnicas de correlación de registros para sistemas multihilo
- Análisis de las trazas de pila de ThreadPoolExecutor para la detección de interbloqueos
- Correlación de los estados de los subprocesos a lo largo de trazas de pila complejas
- Stack Trace Detective: Depuración de fallos en procesos multihilo
- Prueba de conocimientos sobre análisis de depuración multihilo
- Evaluación de dominio de la depuración multihilo en entornos de producción
UNIDAD 53 - Proyecto: Calidad de los datos y depuración para garantizar la fiabilidad de los flujos de datos · 5 leccionesCalidad y depuración de datos para canalizaciones fiables - UNIDAD 53 - Proyecto: Calidad de los datos y depuración para garantizar la fiabilidad de los flujos de datos
Calidad y depuración de datos para canalizaciones fiables - UNIDAD 53 - Proyecto: Calidad de los datos y depuración para garantizar la fiabilidad de los flujos de datos
- Por qué es importante este proyecto
- Requisitos del proyecto
- Proyecto: Sistema de control de calidad y depuración del flujo de datos
- Cuestionario calificado: Calidad de los datos y depuración para flujos de trabajo fiables
- Clave de la solución
UNIDAD 54 - GenAI: Ingeniería de datos potenciada por IA: DevOps, rendimiento y calidad · 6 leccionesCalidad y depuración de datos para canalizaciones fiables - UNIDAD 54 - GenAI: Ingeniería de datos potenciada por IA: DevOps, rendimiento y calidad
Calidad y depuración de datos para canalizaciones fiables - UNIDAD 54 - GenAI: Ingeniería de datos potenciada por IA: DevOps, rendimiento y calidad
- Descubre cómo la IA transforma tu flujo de trabajo de ingeniería de datos
- Herramientas de IA generativa a lo largo del ciclo de vida de la ingeniería de datos
- Implementación de flujos de trabajo asistidos por IA: de DevOps a la depuración
- Análisis de la estrategia de IA ante los retos de la ingeniería
- Diseño de un flujo de trabajo de ingeniería de datos potenciado por IA
- Prueba de conocimientos: Ingeniería de datos potenciada por la IA: DevOps, rendimiento y calidad
UNIDAD 55 - Inteligencia de carrera en ingeniería de datos · 10 leccionesDesarrollo profesional para la ingeniería de datos de código abierto - UNIDAD 55 - Inteligencia de carrera en ingeniería de datos
Desarrollo profesional para la ingeniería de datos de código abierto - UNIDAD 55 - Inteligencia de carrera en ingeniería de datos
- Inteligencia de carrera en ingeniería de datos
- Estrategia de cartera para ingenieros de datos
- Preparación para entrevistas de trabajo en puestos de ingeniería de datos
- Cómo posicionar tus capacidades en ingeniería de datos
- Cómo orientarse en el mercado laboral de la ingeniería de datos para principiantes
- Prueba de evaluación para ingenieros de datos principiantes
- Recursos seleccionados para ingenieros de datos
- Un día en la vida: visualiza tu carrera profesional en ingeniería de datos
- hoja de ruta de 30 días para lanzar una carrera profesional
- Último punto de control: Ingeniería de datos
Certificado con validez SEP: lo emite la SEP, no solo una plataforma
Al demostrar la competencia recibes un certificado emitido por la Secretaría de Educación Pública a través del Gobierno del Estado de México: un documento oficial que puedes presentar con confianza ante cualquier empleador o institución.
Tu certificado con INEC
- Lo emite la Secretaría de Educación Pública (SEP), a través del Gobierno del Estado de México
- Documento oficial con folio verificable en línea
- Lo otorga la Universidad Tecnológica Fidel Velázquez
Otras plataformas en línea
- Constancia privada emitida por la misma plataforma
- Solo acredita horas cursadas o asistencia
- Sin respaldo de una autoridad educativa
Tu itinerario, de la inscripción al certificado
- 1
Inscripción con pago único
Pagas $4,990 MXN una sola vez y entras de inmediato al curso.
- 2
Estudias a tu ritmo
55 unidades con videos, lecturas y actividades, disponibles 24/7 durante 12 meses.
- 3
Cuestionarios por unidad
93 cuestionarios para comprobar lo aprendido.
- 4
Certificado
Emitido por la SEP a través del Gobierno del Estado de México, con folio verificable.
Un certificado oficial de la SEP
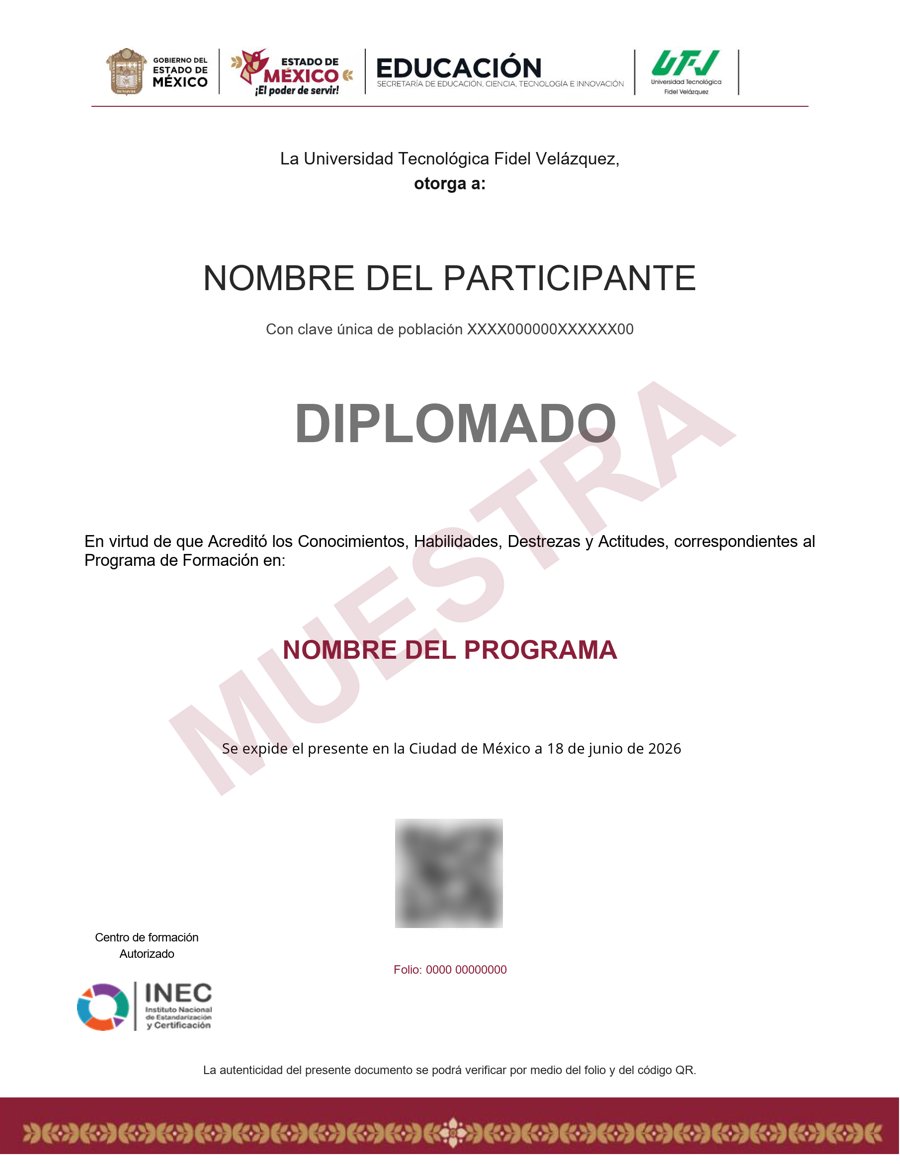
Muestra · verificable por folio y QR
- Certificado SEP incluido (sin costo). Emitido por la Secretaría de Educación Pública (SEP), a través del Gobierno del Estado de México. No es una constancia privada: es un documento oficial, y ese respaldo marca la diferencia frente a otras plataformas en línea.
- Contenido impartido por Coursera.
- Folio y QR verificables para compartirlo con quien te contrate.
Empieza hoy, a tu ritmo
Un solo pago y acceso inmediato al curso completo durante 12 meses.
- 55 unidades · 362 lecciones · 240 h
- 12 meses de acceso
- 93 cuestionarios de evaluación
- Certificado SEP incluido (sin costo), emitido por la SEP (Gob. del Estado de México) con folio verificable
Sobre tu inscripción
¿Cómo es el pago?
Un solo pago de $4,990 MXN. No hay mensualidades ni cargos recurrentes.
¿Cuánto tiempo tengo acceso?
12 meses desde tu inscripción, 24/7, para avanzar a tu ritmo.
¿Quién imparte el contenido?
El curso es impartido por Coursera; INEC gestiona tu inscripción, evaluación y certificado.
¿Qué pasa cuando vence mi acceso?
Puedes renovar tu cuenta tú mismo desde la plataforma, sin trámites ni esperas.
¿El curso tiene validez SEP?
Sí, incluido sin costo. Al completar el curso recibes un certificado emitido por la SEP a través del Gobierno del Estado de México, con folio verificable.
¿El curso tiene tutor o clases en vivo?
No. Es un curso autodidacta: estudias por tu cuenta, a tu ritmo, sin tutor ni sesiones en vivo.
¿Cómo se evalúa?
Te evalúas con actividades automáticas, sin entregas a un tutor.